بررسی کامل سرویسهای LTE اپراتورهای تلفن همراه در ایران
امروزه کیفیت اینترنت موبایل و اینترنت ثابت بیسیم یکی از مهمترین شاخصهای انتخاب اپراتور برای کاربران ایرانی...
پرایم | کامل ترین اسکریپت فروشگاهی
هوش مصنوعی چگونه شکل گرفت، چه مراحلی را پشت سر گذاشت و آینده آن چگونه خواهد بود؟
هوش مصنوعی (Artificial Intelligence یا AI) یکی از مهمترین دستاوردهای علمی و فناوری در دنیای معاصر است؛ فناوریای که به ماشینها و نرمافزارها امکان میدهد وظایفی مانند تحلیل اطلاعات، تشخیص الگوها، درک زبان، تولید محتوا، حل مسئله و تصمیمگیری را انجام دهند. آنچه امروز در قالب دستیارهای هوشمند، خودروهای خودران، سامانههای تشخیص پزشکی و ابزارهای تولید تصویر و متن میبینیم، حاصل چند دهه پژوهش و مجموعهای از پیشرفتهای علمی است که ریشههای آن به پیش از پیدایش رایانههای مدرن بازمیگردد.
با این حال، تاریخ هوش مصنوعی مسیری مستقیم و بدون وقفه نبوده است. این حوزه دورههایی از خوشبینی شدید، موفقیتهای علمی، کمبود منابع مالی، شکستهای فنی و جهشهای بزرگ را تجربه کرده است. در برخی دورهها، دانشمندان تصور میکردند ساخت ماشینهایی با تواناییهای نزدیک به انسان تنها چند سال فاصله دارد؛ اما محدودیت سختافزار، کمبود داده و پیچیدگی یادگیری و استدلال باعث شد تحقق بسیاری از این پیشبینیها دههها طول بکشد.
در این مقاله، تاریخ هوش مصنوعی را از ریشههای نظری آن تا ظهور یادگیری ماشین، یادگیری عمیق، مدلهای زبانی بزرگ و هوش مصنوعی مولد بررسی میکنیم و در پایان، مهمترین فرصتها، چالشها و مسیرهای احتمالی آینده این فناوری را توضیح میدهیم.
هوش مصنوعی شاخهای از علوم رایانه است که بر طراحی و توسعه سیستمهایی تمرکز دارد که میتوانند کارهایی را انجام دهند که معمولاً به برخی تواناییهای شناختی انسان نیاز دارند. این تواناییها ممکن است شامل یادگیری از تجربه، تشخیص الگو، پردازش زبان طبیعی، برنامهریزی، استدلال، درک تصویر و انتخاب میان گزینههای مختلف باشند.
برای مثال، هنگامی که یک سامانه ایمیل پیامهای ناخواسته را شناسایی میکند، یک فروشگاه اینترنتی محصولات مرتبط با علایق مشتری را پیشنهاد میدهد یا یک ابزار هوشمند از روی توضیحات متنی تصویر تولید میکند، از روشهای مختلف هوش مصنوعی استفاده میشود.
نکته مهم این است که هوش مصنوعی لزوماً به معنای داشتن آگاهی، احساس یا درک انسانی نیست. یک سامانه میتواند در انجام وظیفهای مشخص بسیار توانمند باشد، بدون آنکه شواهدی داشته باشیم که نشان دهد مانند انسان تجربه ذهنی یا خودآگاهی دارد.
این سه اصطلاح ارتباط نزدیکی با یکدیگر دارند، اما معنای یکسانی ندارند.
هوش مصنوعی: حوزه گستردهای از روشها برای ایجاد سیستمهای دارای رفتار هوشمند.
یادگیری ماشین (Machine Learning): زیرمجموعهای از هوش مصنوعی که در آن مدلها با استفاده از دادهها و تجربه، الگوها را یاد میگیرند.
یادگیری عمیق (Deep Learning): زیرمجموعهای از یادگیری ماشین که از شبکههای عصبی دارای لایههای متعدد استفاده میکند.
برای درک بهتر، تصور کنید میخواهیم سامانهای برای تشخیص پیامهای تبلیغاتی ناخواسته بسازیم. در روش مبتنی بر قواعد، برنامهنویس فهرستی از شرایط را تعیین میکند. در یادگیری ماشین، مدل با بررسی نمونههای پیامهای سالم و ناخواسته، الگوهای مرتبط را میآموزد. در یادگیری عمیق، شبکه عصبی میتواند بازنماییهای پیچیدهتری از متن و روابط میان کلمات را یاد بگیرد.
این روشها جایگزین مطلق یکدیگر نیستند. حتی در سامانههای هوشمند امروزی، قواعد صریح، الگوریتمهای کلاسیک، یادگیری ماشین و شبکههای عصبی ممکن است در کنار هم استفاده شوند.
ایده ساخت ماشینهایی که بتوانند بخشی از فعالیتهای ذهن انسان را انجام دهند، بسیار قدیمیتر از فناوری دیجیتال است. انسانها قرنها درباره امکان مکانیکیکردن محاسبه و استدلال اندیشیدهاند.
در قرن هفدهم، فیلسوفان و ریاضیدانانی مانند گوتفرید ویلهلم لایبنیتس به این موضوع پرداختند که آیا میتوان بخشی از استدلال انسانی را با نمادها، قواعد و محاسبات صوری نمایش داد. این تلاشها هنوز هوش مصنوعی به معنای امروزی آن نبودند، اما به شکلگیری ایده مهمی کمک کردند: شاید بتوان برخی فرایندهای فکری را به صورت عملیاتی دقیق و قابل اجرا بیان کرد.
در قرن نوزدهم نیز آدا لاولیس در بررسی ماشین تحلیلی چارلز ببیج به قابلیتهای محاسباتی ماشینها پرداخت. اهمیت کار او در این بود که محاسبات ماشینی را فراتر از انجام عملیات حسابی ساده در نظر گرفت؛ هرچند درباره اینکه ماشینها میتوانند واقعاً ایدههای تازه تولید کنند یا خیر، دیدگاه او محدودیتهایی را نیز مطرح میکرد.
پیشرفتهای ریاضیات، منطق و نظریه محاسبات در قرن بیستم زمینه را برای طرح علمیتر این پرسش فراهم کردند که آیا میتوان رفتارهایی شبیه هوش را در ماشین پیادهسازی کرد.
یکی از رویدادهای مهم در ریشههای علمی هوش مصنوعی، مقاله سال ۱۹۴۳ وارن مککالاک و والتر پیتس بود. آنها مدلی ریاضی از نورونهای ساده ارائه کردند و نشان دادند چگونه شبکههایی از واحدهای محاسباتی ساده میتوانند برخی عملیات منطقی را انجام دهند.
این ایده اهمیت زیادی داشت؛ زیرا ارتباطی میان شبکههای عصبی زیستی، منطق ریاضی و محاسبات ایجاد میکرد. پژوهشگران بعدها از این مسیر برای توسعه شبکههای عصبی مصنوعی استفاده کردند.
در همین دوره، توسعه رایانههای الکترونیکی و پیشرفت در رمزنگاری، محاسبات عددی و مهندسی، امکان اجرای برنامههای پیچیدهتر را فراهم کرد. رایانهها بهتدریج از ماشینهای تخصصی محاسباتی به ابزارهایی تبدیل شدند که میتوانستند برای پردازش انواع اطلاعات برنامهریزی شوند.
با وجود این، سختافزارهای آن زمان بسیار محدود بودند. حافظه کم، سرعت پایین و هزینه بالای محاسبات، اجرای الگوریتمهایی را که امروزه عادی به نظر میرسند دشوار میکرد.
در سال ۱۹۵۰، آلن تورینگ، ریاضیدان بریتانیایی، مقاله مشهور خود با عنوان «ماشینهای محاسباتی و هوش» را منتشر کرد. او بهجای گرفتارشدن در تعریف فلسفی و مبهم تفکر، پیشنهاد کرد مسئله را از طریق رفتار قابل مشاهده بررسی کنیم.
این رویکرد به ایدهای انجامید که بعدها با نام آزمون تورینگ شناخته شد. در شکل متداول این آزمون، ارزیاب با یک انسان و یک ماشین از طریق متن تعامل میکند و باید تشخیص دهد کدامیک ماشین است.
اگر ماشین بتواند در این شرایط ارزیاب را فریب دهد، ممکن است در آن تعامل رفتاری شبیه انسان نشان داده باشد. با این حال، آزمون تورینگ معیار جامع و قطعی هوش، فهم یا آگاهی نیست. یک سامانه میتواند مکالمهای قانعکننده داشته باشد، اما در استدلال، دقت واقعی یا شناخت جهان محدودیتهایی جدی نشان دهد.
اهمیت کار تورینگ در این بود که پرسش هوش ماشینی را به موضوعی جدی برای پژوهش علمی تبدیل کرد و بحث درباره معیارهای ارزیابی رفتار هوشمند را گسترش داد.
نقطه عطف تاریخ هوش مصنوعی معمولاً به تابستان سال ۱۹۵۶ و کارگاه تحقیقاتی دارتموث در ایالات متحده نسبت داده میشود. این رویداد با مشارکت پژوهشگرانی از جمله جان مککارتی، ماروین مینسکی، ناتانیل روچستر و کلود شنون شکل گرفت.
اصطلاح «هوش مصنوعی» در پیشنهاد برگزاری این پروژه در سال ۱۹۵۵ به کار رفت و کارگاه سال ۱۹۵۶ بهطور گسترده بهعنوان نقطه آغاز رسمی این رشته شناخته میشود.
پژوهشگران امیدوار بودند جنبههای مختلف یادگیری و هوش را بتوان آنقدر دقیق توصیف کرد که ماشینها قادر به شبیهسازی آنها باشند. این امید، زمینهساز شکلگیری یک حوزه پژوهشی مستقل شد.
در سالهای بعد، پژوهشها عمدتاً بر نمایش نمادین دانش، منطق، حل مسئله و جستوجوی مسیرهای رسیدن به پاسخ متمرکز بودند. هدف این بود که ماشین بتواند با استفاده از قواعد و نمادها، مسائل را مرحلهبهمرحله حل کند.
در دهههای نخست، محققان برنامههایی ساختند که میتوانستند برخی مسائل منطقی و ریاضی را حل کنند یا در محیطهای محدود تصمیم بگیرند.
یکی از نمونههای مشهور، برنامه Logic Theorist بود که در میانه دهه ۱۹۵۰ توسط آلن نیوئل، هربرت سایمون و کلیف شاو توسعه یافت. این برنامه قادر بود برخی قضیههای منطق ریاضی را اثبات کند و نشان داد که رایانه میتواند فرایندهایی فراتر از محاسبه عددی ساده انجام دهد.
در سال ۱۹۵۷، فرانک روزنبلات پرسپترون را توسعه داد؛ مدلی از شبکه عصبی که میتوانست با تنظیم وزنهای خود، برخی الگوها را تشخیص دهد. پرسپترون یکی از پیشگامان یادگیری از دادهها بود، اما نسخههای ساده آن نمیتوانستند همه انواع مسائل را حل کنند.
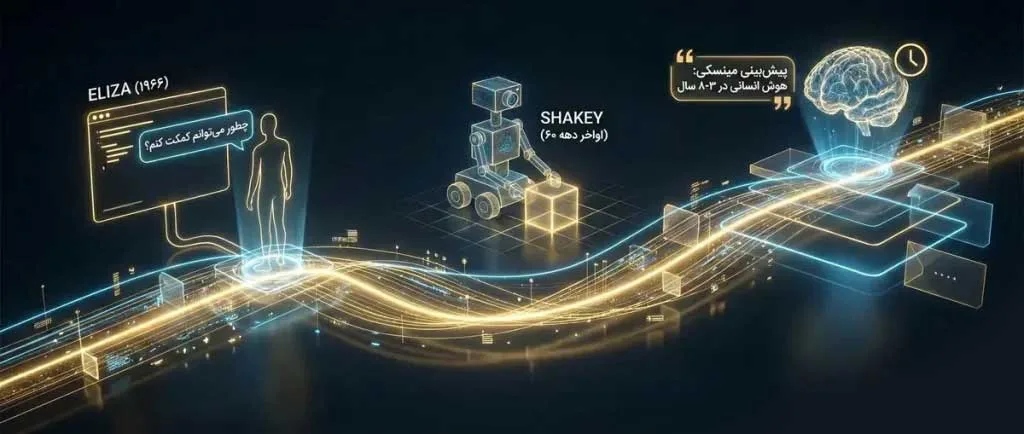
در سال ۱۹۶۶ نیز جوزف وایزنباوم در مؤسسه فناوری ماساچوست، برنامه ELIZA را توسعه داد. این برنامه با استفاده از الگوهای متنی و قواعد ساده، به ورودی کاربران پاسخ میداد و در برخی مکالمات، احساس گفتوگو با یک انسان را ایجاد میکرد.
ELIZA در واقع فهم عمیق زبان نداشت، اما نشان داد که حتی پاسخهای نسبتاً ساده میتوانند برداشت انسان از هوشمندی یک ماشین را تحت تأثیر قرار دهند.
موفقیتهای اولیه انتظارات زیادی ایجاد کردند، اما سیستمهای آن دوره معمولاً در محیطهای محدود عملکرد مناسبی داشتند. آنها در مواجهه با مسائل پیچیده، دادههای ناقص، تغییر شرایط و موقعیتهایی خارج از قواعد تعریفشده، بهسرعت دچار مشکل میشدند.
این فاصله میان وعدهها و تواناییهای واقعی، در سالهای بعد به کاهش حمایت مالی از برخی پروژههای هوش مصنوعی منجر شد.
اصطلاح «زمستان هوش مصنوعی» به دورههایی گفته میشود که انتظارات از این فناوری کاهش مییابد و بودجه، سرمایهگذاری یا توجه عمومی به پژوهشهای آن محدود میشود.
در دهه ۱۹۷۰، بخشی از پژوهشگران و سرمایهگذاران دریافتند که دستاوردهای اولیه برای تحقق وعدههای بزرگ کافی نیستند. محدودیت توان پردازشی، کمبود داده و دشواری حل مسائل واقعی، پیشرفت را کند کرده بود.
یکی از عوامل مهم، شکاف میان مسائل کوچک آزمایشگاهی و دنیای واقعی بود. برنامهای که در یک محیط کنترلشده مسئلهای را حل میکرد، الزاماً نمیتوانست همان روش را در محیطی پیچیده و نامطمئن به کار بگیرد.
در بریتانیا، گزارش لایتهیل در سال ۱۹۷۳ به انتقاد از برخی ادعاهای پژوهشهای هوش مصنوعی پرداخت و در کاهش حمایت از تعدادی از پروژهها نقش داشت.
البته این دوره به معنای توقف کامل پیشرفت نبود. پژوهش در منطق، بازنمایی دانش، شبکههای عصبی و الگوریتمهای جستوجو ادامه یافت. تجربه این سالها به جامعه علمی آموخت که توسعه هوش مصنوعی به ارزیابی واقعبینانهتر، روشهای مؤثرتر و منابع محاسباتی بیشتر نیاز دارد.
در دهه ۱۹۸۰، سیستمهای خبره (Expert Systems) به یکی از مهمترین شاخههای کاربردی هوش مصنوعی تبدیل شدند.
این سیستمها دانش متخصصان را در قالب قواعد و پایگاههای دانش ذخیره میکردند و با استفاده از موتور استنتاج، برای مسائل مشخص پیشنهاد یا نتیجه تولید میکردند.
برای مثال، یک سیستم خبره پزشکی میتوانست با دریافت نشانهها و اطلاعات بیمار، بر اساس مجموعهای از قواعد، تشخیصهای احتمالی را پیشنهاد دهد. در صنعت نیز از این سیستمها برای پیکربندی تجهیزات، عیبیابی و پشتیبانی از تصمیمگیری استفاده میشد.
یکی از نمونههای تجاری شناختهشده، سیستم XCON بود که برای پیکربندی سفارشهای رایانهای در شرکت DEC به کار رفت.
سیستمهای خبره نشان دادند که هوش مصنوعی میتواند ارزش اقتصادی واقعی ایجاد کند؛ بهخصوص زمانی که مسئله مشخص باشد و دانش مورد نیاز را بتوان به قواعد صریح تبدیل کرد.
با این حال، ساخت و نگهداری پایگاههای دانش پرهزینه بود. هرچه محیط پیچیدهتر میشد، تعداد قواعد افزایش مییافت و هماهنگکردن آنها دشوارتر میشد. این سیستمها همچنین در یادگیری خودکار از حجم زیادی از دادهها محدودیت داشتند.
با کاهش جذابیت تجاری برخی سیستمهای خبره و برآوردهنشدن انتظارات از پروژههای بزرگ، بار دیگر حمایت مالی از بخشهایی از هوش مصنوعی کاهش یافت.
سیستمهای مبتنی بر قواعد در بسیاری از موقعیتها شکننده بودند؛ یعنی تغییر کوچک در شرایط یا ورود اطلاعات پیشبینینشده میتوانست عملکرد آنها را مختل کند. هزینه توسعه و نگهداری نیز برای بسیاری از سازمانها بالا بود.
با این حال، این دوره نیز به معنای پایان پژوهش نبود. الگوریتمهای آماری، یادگیری ماشین، پردازش زبان طبیعی و شبکههای عصبی به پیشرفت خود ادامه دادند. بهتدریج، رویکردی تقویت شد که بهجای تعریف همه قواعد بهصورت دستی، تلاش میکرد الگوها را از دادهها استخراج کند.
در دهه ۱۹۹۰، یادگیری ماشین بهتدریج جایگاه برجستهتری در پژوهش و کاربردهای صنعتی پیدا کرد. افزایش قدرت رایانهها، توسعه الگوریتمهای آماری و دسترسی بهتر به دادهها، امکان ساخت مدلهایی را فراهم کرد که از نمونههای واقعی یاد میگرفتند.
در روشهای سنتی مبتنی بر قواعد، برنامهنویس باید بخش زیادی از منطق تصمیمگیری را بهصورت مستقیم تعریف میکرد. در یادگیری ماشین، هدف این بود که مدل با مشاهده دادههای نمونه، روابط و الگوهای مفید را بیاموزد.
الگوریتمهایی مانند درخت تصمیم، ماشین بردار پشتیبان، روشهای بیزی و مدلهای آماری در حوزههایی نظیر تشخیص الگو، دستهبندی اسناد، پیشبینی و تحلیل داده کاربرد پیدا کردند.
در سال ۱۹۹۷، رایانه Deep Blue شرکت IBM توانست گری کاسپاروف، قهرمان برجسته شطرنج جهان، را در یک مسابقه رسمی ششدستگاهی شکست دهد.
این اتفاق یکی از مشهورترین نقاط عطف تاریخ هوش مصنوعی بود. Deep Blue از توان محاسباتی بالا، جستوجوی گسترده حرکات و توابع ارزیابی برای بررسی موقعیتهای شطرنج استفاده میکرد.
این پیروزی نشان داد که ماشین میتواند در یک وظیفه پیچیده فکری از بهترین انسانها پیشی بگیرد. البته این موفقیت به معنای داشتن هوش عمومی مشابه انسان نبود؛ Deep Blue برای یک مسئله تخصصی طراحی شده بود و نمیتوانست مانند یک انسان در حوزههای گوناگون یاد بگیرد و عمل کند.
در دهه ۲۰۰۰، چند تحول همزمان مسیر هوش مصنوعی را تغییر دادند:
گسترش اینترنت و تولید حجم زیادی از دادههای دیجیتال
افزایش توان پردازشی رایانهها
توسعه پردازندههای گرافیکی (GPU)
پیشرفت الگوریتمهای یادگیری ماشین
افزایش ظرفیت ذخیرهسازی و کاهش هزینه دسترسی به دادهها
شبکههای عصبی از قبل مطرح شده بودند، اما آموزش شبکههای بزرگ به منابع محاسباتی و دادهای قابلتوجه نیاز داشت. پیشرفت سختافزار و دسترسی به مجموعهدادههای بزرگتر، امکان آموزش مدلهای پیچیدهتر را فراهم کرد.
در سال ۲۰۰۶، پژوهشهای جفری هینتون و همکارانش به احیای توجه به شبکههای عصبی عمیق کمک کرد. این جریان بعدها با نام یادگیری عمیق شناخته شد و به یکی از پایههای اصلی هوش مصنوعی مدرن تبدیل گردید.
در این دوره، هوش مصنوعی بهتدریج از محیطهای پژوهشی محدود فراتر رفت و در جستوجوی اینترنتی، تبلیغات هدفمند، پیشنهاد محتوا، تشخیص گفتار و تحلیل دادههای تجاری کاربرد گستردهتری پیدا کرد.
در سال ۲۰۱۱، سامانه Watson شرکت IBM در مسابقه تلویزیونی Jeopardy! توانست از رقبای انسانی خود پیشی بگیرد. این مسابقه به دلیل پرسشهای زبانی، بازی با کلمات و نیاز به بازیابی اطلاعات، چالش متفاوتی نسبت به شطرنج محسوب میشد.
Watson از روشهای مختلف پردازش زبان طبیعی، بازیابی اطلاعات و ارزیابی پاسخها استفاده میکرد. این موفقیت توجه زیادی را به توانایی رایانهها در تحلیل پرسشهای زبانی و ترکیب اطلاعات جلب کرد.
در همان سالها، دستیارهای صوتی و خدمات تشخیص گفتار نیز بهتدریج در دسترس کاربران بیشتری قرار گرفتند. این تحولات زمینهساز ارتباط طبیعیتر میان انسان و رایانه شدند.
سال ۲۰۱۲ یکی از نقاط عطف مهم در تاریخ هوش مصنوعی مدرن است. مدل AlexNet در رقابت تشخیص تصویر ImageNet عملکردی چشمگیر نشان داد و نقش شبکههای عصبی عمیق را در بینایی ماشین برجسته کرد.
این موفقیت حاصل یک عامل واحد نبود؛ ترکیب دادههای تصویری بزرگ، معماری مناسب شبکه عصبی، استفاده از پردازندههای گرافیکی و روشهای مؤثر آموزش اهمیت داشت.
پس از این رویداد، یادگیری عمیق بهسرعت در حوزههای مختلف توسعه یافت، از جمله:
تشخیص اشیا و چهرهها در تصاویر
تبدیل گفتار به متن
ترجمه ماشینی
تحلیل تصاویر پزشکی
شناسایی الگوهای پیچیده در دادهها
پردازش و طبقهبندی اسناد
تفاوت مهم یادگیری عمیق با بسیاری از روشهای پیشین این بود که مدل میتوانست بخش بزرگی از ویژگیهای مورد نیاز برای حل مسئله را مستقیماً از دادهها بیاموزد. این قابلیت، وابستگی به طراحی دستی ویژگیها را در بسیاری از کاربردها کاهش داد.
بازی گو به دلیل تعداد بسیار زیاد وضعیتهای ممکن، مدتها یکی از چالشهای دشوار هوش مصنوعی به شمار میرفت.
در سال ۲۰۱۶، سامانه AlphaGo شرکت DeepMind توانست لی سدول، بازیکن برجسته گو، را با نتیجه چهار بر یک شکست دهد. این دستاورد ترکیبی از شبکههای عصبی عمیق، جستوجوی درختی و یادگیری تقویتی بود.
یادگیری تقویتی روشی است که در آن عامل با تعامل با محیط و دریافت پاداش یا جریمه، بهتدریج سیاستهای تصمیمگیری خود را بهبود میدهد.
AlphaGo نشان داد که ترکیب یادگیری از دادهها با جستوجو و ارزیابی میتواند در مسائلی که فضای تصمیمگیری بسیار بزرگی دارند، عملکردی فراتر از روشهای سنتی ایجاد کند.
اهمیت این رویداد تنها در شکست یک قهرمان انسانی نبود؛ بلکه نشان داد ماشینها میتوانند راهبردهایی پیدا کنند که لزوماً از تقلید مستقیم رفتار انسان به دست نمیآیند.
یکی از مهمترین تحولات فنی هوش مصنوعی در سال ۲۰۱۷ رخ داد. گروهی از پژوهشگران مقاله «Attention Is All You Need» را منتشر کردند که معماری ترنسفورمر (Transformer) را معرفی میکرد.
ترنسفورمر از سازوکار توجه (Attention) برای مدلسازی روابط میان بخشهای مختلف داده استفاده میکند. در پردازش متن، این روش به مدل کمک میکند ارتباط میان کلمات و بخشهای دور از یکدیگر را بررسی کند.
یکی از مزیتهای مهم این معماری، امکان پردازش موازیتر دادهها در مرحله آموزش نسبت به بسیاری از معماریهای بازگشتی پیشین بود. این ویژگی، همراه با پیشرفت سختافزار و افزایش حجم دادههای آموزشی، به توسعه مدلهای بسیار بزرگ کمک کرد.
ترنسفورمر بعدها به پایه فنی بسیاری از مدلهای زبانی بزرگ و سامانههای چندوجهی تبدیل شد.
در واقع، انقلاب هوش مصنوعی مولد نتیجه یک اختراع منفرد نبود؛ بلکه از ترکیب معماریهای بهتر، دادههای گسترده، توان محاسباتی بالاتر و روشهای جدید آموزش شکل گرفت.
در این دوره، مدلهای زبانی مبتنی بر ترنسفورمر بهسرعت توسعه یافتند. مدلهایی مانند BERT و خانواده GPT نشان دادند که آموزش روی حجم بزرگی از متن میتواند بازنماییهای مفیدی از زبان ایجاد کند.
مدل BERT برای درک متن و استخراج روابط زبانی در وظایفی مانند پاسخگویی به پرسشها و دستهبندی متن اهمیت پیدا کرد. خانواده GPT نیز مسیر توسعه مدلهایی را دنبال کرد که با پیشبینی ادامه متن آموزش میدیدند و میتوانستند متنهای تازه تولید کنند.
مدلهای زبانی بزرگ (Large Language Models یا LLMs) معمولاً تعداد بسیار زیادی پارامتر دارند. پارامترها مقادیر قابلآموزشی هستند که در جریان آموزش تنظیم میشوند تا مدل الگوهای آماری دادهها را بیاموزد.
این مدلها با پیشآموزش روی مجموعههای بزرگ متن و سپس تنظیم برای کاربردهای خاص، توانستند در کارهایی مانند خلاصهسازی، ترجمه، تکمیل متن، پاسخگویی و تولید کد عملکردهای چشمگیری نشان دهند.
با این حال، بزرگترشدن مدل بهتنهایی تضمینکننده صحت، استدلال درست یا قابلاعتمادبودن پاسخها نیست. کیفیت دادهها، طراحی آموزش، روش ارزیابی و سازوکارهای کنترل خروجی نیز اهمیت اساسی دارند.
در سال ۲۰۲۲، ابزارهای هوش مصنوعی مولد توجه عمومی بسیار گستردهای به خود جلب کردند. انتشار عمومی ChatGPT در نوامبر ۲۰۲۲، یکی از مهمترین رویدادهای این دوره بود؛ زیرا امکان تعامل با یک مدل زبانی قدرتمند را از طریق گفتوگویی ساده در اختیار طیف وسیعی از کاربران قرار داد.
همزمان، ابزارهای تولید تصویر از متن نیز تواناییهای مدلهای مولد را برای عموم ملموس کردند. کاربران میتوانستند بهجای کار مستقیم با نرمافزارهای پیچیده، درخواست خود را به زبان طبیعی بیان کنند و خروجی متنی یا تصویری دریافت کنند.
هوش مصنوعی مولد (Generative AI) به مدلهایی گفته میشود که میتوانند محتوای جدید تولید کنند؛ از جمله متن، تصویر، صدا، موسیقی، ویدئو یا کد برنامهنویسی.
این مدلها معمولاً با یادگیری الگوهای موجود در دادههای آموزشی، خروجیهایی تولید میکنند که از نظر آماری با آن الگوها سازگارند. تولید محتوا لزوماً به این معنا نیست که مدل مانند انسان معنای اثر را درک میکند یا همه جزئیات آن را از نظر واقعیت بررسی میکند.
اهمیت ChatGPT فقط در توانایی پاسخگویی به پرسشها نبود. این ابزار نشان داد که رابط گفتوگویی میتواند استفاده از فناوریهای پیچیده را برای کاربران عادی آسان کند.
کاربر برای شروع کار لزوماً به دانش برنامهنویسی یا شناخت معماری مدل نیاز نداشت. میتوانست متنی بنویسد، سؤال بپرسد، از مدل بخواهد متن را بازنویسی کند یا در حل یک مسئله کمک بگیرد.
این سادگی تعامل، مسیر استفاده از هوش مصنوعی را در آموزش، برنامهنویسی، تولید محتوا، پشتیبانی مشتریان و فعالیتهای اداری تغییر داد.
با این حال، پاسخهای روان و قانعکننده همیشه صحیح نیستند. مدلهای زبانی ممکن است اطلاعات نادرست تولید کنند، منابعی را اشتباه معرفی کنند یا در جزئیات تخصصی دچار خطا شوند. بنابراین، بررسی خروجی در کاربردهای حساس همچنان ضروری است.
پس از استقبال گسترده از ابزارهای گفتوگومحور، شرکتهای فناوری و سازمانها سرمایهگذاری بیشتری در مدلهای مولد، زیرساخت پردازشی و محصولات مبتنی بر هوش مصنوعی انجام دادند.
در این دوره، مدلهای زبانی در انجام کارهای چندمرحلهای، تحلیل اسناد، تولید کد، خلاصهسازی و پاسخگویی به پرسشهای تخصصی پیشرفت کردند. ابزارهای تولید تصویر و ویدئو نیز کیفیت و تنوع بیشتری پیدا کردند.
یکی از روندهای مهم، حرکت به سوی هوش مصنوعی چندوجهی (Multimodal AI) بود. این سیستمها میتوانند بیش از یک نوع داده، مانند متن، تصویر، صوت و در برخی موارد ویدئو، را پردازش کنند.
برای مثال، کاربر ممکن است تصویری را به مدل بدهد و درباره محتوای آن سؤال بپرسد، یک پیام صوتی ارسال کند یا از سیستم بخواهد اطلاعات یک سند را استخراج و خلاصه کند.
همچنین استفاده از بازیابی اطلاعات و اتصال مدلها به منابع بیرونی توسعه یافت. در روشهایی مانند تولید تقویتشده با بازیابی (Retrieval-Augmented Generation یا RAG)، مدل پیش از پاسخگویی میتواند اطلاعات مرتبط را از یک مجموعه اسناد یا پایگاه دانش بازیابی کند. این روش به استفاده از اطلاعات اختصاصی و بهروز کمک میکند، هرچند بهتنهایی صحت همه پاسخها را تضمین نمیکند.
در کسبوکارها، تمرکز بهتدریج از آزمایش ابزارهای عمومی به طراحی فرایندهای مشخص تغییر کرد؛ مانند پاسخگویی به مشتری، جستوجو در اسناد داخلی، تحلیل گزارشها و کمک به توسعه نرمافزار.
در میانه دهه ۲۰۲۰، توسعه هوش مصنوعی تنها بر افزایش اندازه مدلها متمرکز نماند. بهبود توان حل مسئله، استفاده از ابزارها، تحلیل چندمرحلهای و انجام وظایف پیچیدهتر نیز به موضوعات مهم پژوهش و توسعه تبدیل شدند.
مدلهای جدیدتر در برخی خانوادهها از روشهایی بهره میگیرند که منابع محاسباتی بیشتری را هنگام پاسخگویی به مسائل دشوار اختصاص میدهند. این رویکرد میتواند در برخی وظایف، مانند مسائل ریاضی یا برنامهنویسی، کیفیت پاسخ را افزایش دهد؛ اما میزان بهبود به نوع مسئله و مدل بستگی دارد.
عاملهای هوش مصنوعی (AI Agents) نیز مورد توجه قرار گرفتهاند. یک عامل هوشمند، بسته به طراحی خود، میتواند هدفی را دریافت کند، مراحل انجام کار را برنامهریزی کند، از ابزارهای مجاز استفاده کند و نتیجه را بررسی کند. برای نمونه، یک عامل ممکن است در محیطی کنترلشده اسناد را جستوجو کند، اطلاعات مورد نیاز را استخراج کند و گزارشی تهیه کند.
با این حال، عاملها هنوز به نظارت، محدودیت دسترسی، کنترل خطا و ارزیابی دقیق نیاز دارند. واگذاری یک وظیفه به سیستم هوشمند به این معنا نیست که آن سیستم در تمام مراحل بدون خطا عمل میکند.
در حوزه چندوجهی نیز مرز میان تعامل متنی، صوتی و تصویری کمتر شده است. با وجود این، قابلیتها در محصولات مختلف متفاوتاند و نباید هر ادعایی درباره هوش عمومی یا خودمختاری کامل را یک دستاورد اثباتشده تلقی کرد.
تا سال ۲۰۲۶، هوش مصنوعی همچنان حوزهای در حال تحول است. برخی قابلیتها در محصولات تجاری در دسترس قرار گرفتهاند، برخی در مرحله آزمایش یا پژوهش هستند و بسیاری از پیشبینیهای مربوط به آینده هنوز قطعیت ندارند.
| سال یا دوره | رویداد مهم | اهمیت |
|---|---|---|
| ۱۹۴۳ | مدل ریاضی نورونهای مصنوعی | شکلگیری یکی از پایههای نظری شبکههای عصبی |
| ۱۹۵۰ | مقاله آلن تورینگ | طرح پرسش هوش ماشینی و ایده آزمون تورینگ |
| ۱۹۵۶ | کارگاه دارتموث | تثبیت هوش مصنوعی بهعنوان حوزه پژوهشی مستقل |
| ۱۹۵۷ | توسعه پرسپترون | گامی اولیه در یادگیری از دادهها |
| ۱۹۶۶ | برنامه ELIZA | نمونه اولیه تعامل متنی با ماشین |
| دهه ۱۹۷۰ | نخستین زمستان هوش مصنوعی | کاهش انتظارات و محدودیت حمایت مالی |
| دهه ۱۹۸۰ | گسترش سیستمهای خبره | کاربرد تجاری قواعد و دانش تخصصی |
| اواخر دهه ۱۹۸۰ و اوایل دهه ۱۹۹۰ | دومین زمستان هوش مصنوعی | آشکارشدن محدودیتهای سیستمهای خبره و پروژههای پرهزینه |
| ۱۹۹۷ | پیروزی Deep Blue در شطرنج | نمایش توان محاسباتی ماشین در یک وظیفه تخصصی |
| ۲۰۰۶ | احیای توجه به شبکههای عمیق | زمینهسازی برای موج جدید یادگیری عمیق |
| ۲۰۱۲ | موفقیت AlexNet | جهش در تشخیص تصویر با شبکههای عصبی عمیق |
| ۲۰۱۶ | پیروزی AlphaGo | پیشرفت در ترکیب یادگیری عمیق و یادگیری تقویتی |
| ۲۰۱۷ | معرفی معماری ترنسفورمر | فراهمشدن یکی از پایههای مدلهای زبانی بزرگ |
| ۲۰۱۸ تا ۲۰۲۱ | رشد مدلهای زبانی بزرگ | بهبود پردازش و تولید متن |
| ۲۰۲۲ | گسترش عمومی هوش مصنوعی مولد | دسترسی سادهتر کاربران به ابزارهای تولید محتوا |
| ۲۰۲۳ تا ۲۰۲۴ | توسعه ابزارهای چندوجهی و سازمانی | گسترش کاربردهای تجاری و حرفهای |
| ۲۰۲۵ تا ۲۰۲۶ | تمرکز بر استدلال، عاملها و اجرای وظایف | حرکت به سمت سیستمهای توانمندتر و تعاملات پیچیدهتر |
این جدول یک مرور فشرده از نقاط عطف مهم است؛ بسیاری از فناوریها طی چندین سال توسعه یافتهاند و نمیتوان پیدایش آنها را صرفاً به یک تاریخ مشخص محدود کرد.
یکی از مهمترین تغییرات تاریخی، تغییر رویکرد در ساخت سیستمهای هوشمند بوده است.
در هوش مصنوعی نمادین، دانش با نمادها، منطق و قواعد صریح نمایش داده میشود. سیستم با اجرای قواعد میتواند نتیجهگیری کند یا مسئلهای را حل کند.
این رویکرد در مسائل محدود و قابلتعریف مؤثر است، اما نوشتن و نگهداری قواعد برای محیطهای پیچیده دشوار میشود.
در یادگیری ماشین، مدل بهجای دریافت تمام قواعد از برنامهنویس، از نمونههای داده برای یادگیری روابط استفاده میکند.
این روش برای پیشبینی، دستهبندی، کشف الگو و تحلیل داده بسیار مفید است. با این حال، کیفیت مدل به دادههای آموزشی، طراحی ویژگیها، روش ارزیابی و شرایط استفاده وابسته است.
یادگیری عمیق با شبکههای عصبی چندلایه، توانایی یادگیری بازنماییهای پیچیده را افزایش داد. این رویکرد بهویژه در تصویر، صوت و زبان پیشرفتهای بزرگی ایجاد کرد.
مدلهای مولد بزرگ با آموزش روی دادههای گسترده میتوانند متن، تصویر، صدا یا انواع دیگری از محتوا تولید کنند. این مدلها در بسیاری از وظایف بهصورت عمومیتر قابل استفادهاند و برای کاربردهای متنوع، با روشهای گوناگون تنظیم یا به ابزارها متصل میشوند.
در مرحله جدیدتر، مدلهای هوش مصنوعی میتوانند در چارچوبهای مشخص به جستوجو، پایگاه داده، نرمافزارها یا ابزارهای اجرایی متصل شوند. این اتصال به آنها امکان میدهد برخی وظایف را فراتر از تولید یک پاسخ متنی انجام دهند.
با وجود این، اتصال به ابزارها مسئله اعتمادپذیری، مجوز دسترسی، امنیت و نظارت را مهمتر میکند.
هوش مصنوعی دیگر به آزمایشگاهها و شرکتهای فناوری محدود نیست. این فناوری در حوزههای گوناگون به کار گرفته میشود، هرچند سطح بلوغ و میزان اطمینان در هر حوزه متفاوت است.
هوش مصنوعی در تحلیل تصاویر پزشکی، کمک به شناسایی الگوها، پردازش سوابق، پژوهش دارویی و پشتیبانی از تصمیمگیری بالینی کاربرد دارد. خروجی چنین سیستمهایی باید متناسب با کاربرد، کیفیت دادهها و شواهد اعتبارسنجی ارزیابی شود و جایگزین خودکار تشخیص و مسئولیت حرفهای پزشک نیست.
ابزارهای هوشمند میتوانند در توضیح مفاهیم، تمرینسازی، بازخورد آموزشی، ترجمه و شخصیسازی برخی فعالیتهای یادگیری کمک کنند. در مقابل، اتکای بیش از حد به پاسخهای آماده ممکن است یادگیری مستقل را تضعیف کند.
فروشگاههای اینترنتی از هوش مصنوعی برای پیشنهاد محصول، تحلیل رفتار مشتری، دستهبندی پیامها، پیشبینی تقاضا و پشتیبانی استفاده میکنند. مدلهای مولد همچنین میتوانند در تهیه پیشنویس توضیحات محصول و پاسخ به پرسشهای متداول مفید باشند.
تولید پیشنویس مقاله، پیشنهاد عنوان، ایدهپردازی، بازنویسی، خلاصهسازی و آمادهسازی نسخههای متفاوت یک پیام از کاربردهای رایج هوش مصنوعی مولد هستند. با این حال، محتوای نهایی همچنان به بررسی واقعیتها، ویرایش انسانی و رعایت حقوق دیگران نیاز دارد.
بینایی ماشین برای تشخیص عیب محصولات، تحلیل دادههای تجهیزات برای پیشبینی خرابی، بهینهسازی مصرف انرژی و کمک به برنامهریزی تولید استفاده میشود.
هوش مصنوعی میتواند در توضیح کد، تولید پیشنویس، نوشتن آزمونها، یافتن برخی خطاها و مستندسازی کمک کند. اما کد تولیدشده باید بررسی، آزمایش و از نظر امنیتی ارزیابی شود؛ زیرا ممکن است نادرست، ناکارآمد یا آسیبپذیر باشد.
تحلیل ترافیک، پیشبینی تقاضای حملونقل، کمک به مسیریابی و برخی قابلیتهای خودروهای خودران از کاربردهای هوش مصنوعی هستند. میزان خودمختاری و ایمنی این سیستمها به شرایط محیط، سختافزار، نرمافزار و مقررات بستگی دارد.
گسترش هوش مصنوعی فرصتهای متعددی ایجاد کرده است:
افزایش بهرهوری: خودکارسازی برخی کارهای تکراری و زمانبر.
تحلیل سریعتر دادهها: شناسایی الگوهایی که بررسی دستی آنها دشوار است.
دسترسی سادهتر به ابزارها: امکان انجام برخی کارها با زبان طبیعی.
شخصیسازی خدمات: سازگارکردن محتوا و پیشنهادها با نیاز کاربران.
کمک به پژوهش: تحلیل دادهها و تسریع برخی مراحل آزمایش و توسعه.
بهبود دسترسپذیری: کمک به ترجمه، تبدیل گفتار به متن و ابزارهای کمکی.
ایجاد محصولات جدید: فراهمکردن امکان ساخت خدماتی که پیشتر پرهزینه یا دشوار بودند.
این مزایا قطعی و یکسان نیستند؛ نتیجه واقعی به کیفیت پیادهسازی، تناسب فناوری با مسئله و شیوه استفاده وابسته است.
در کنار فرصتها، توسعه هوش مصنوعی پرسشهای فنی، اقتصادی، اجتماعی و حقوقی مهمی ایجاد کرده است.
مدلهای مولد ممکن است پاسخی بسازند که از نظر زبانی قانعکننده است، اما واقعیت ندارد. این مسئله در حوزههای پزشکی، حقوقی، مالی و سایر کاربردهای حساس اهمیت ویژهای دارد.
اگر دادههای آموزشی بازتابدهنده سوگیریهای تاریخی یا اجتماعی باشند، خروجی مدل نیز ممکن است همان سوگیریها را بازتولید کند. ارزیابی منصفانه نیازمند بررسی دادهها و عملکرد سیستم در گروهها و شرایط مختلف است.
ارسال اطلاعات محرمانه به سرویسهای هوش مصنوعی بدون بررسی سیاستهای نگهداری داده، دسترسی و پردازش آنها میتواند خطرآفرین باشد. سازمانها باید مشخص کنند چه دادههایی مجاز به ورود به سیستم هستند و چگونه از آنها محافظت میشود.
آموزش مدلها و استفاده از خروجیهای مولد، پرسشهایی درباره مجوز دادههای آموزشی، شباهت به آثار موجود و حقوق صاحبان آثار ایجاد کرده است. وضعیت حقوقی این مسائل ممکن است بر اساس کشور، نوع استفاده و مقررات مربوط متفاوت باشد.
هوش مصنوعی میتواند برخی وظایف را خودکار کند، برخی مشاغل را تغییر دهد و تقاضا برای مهارتهای تازه ایجاد کند. اثر آن یکسان نیست و به نوع شغل، ساختار سازمان و سرعت سازگاری نیروی کار بستگی دارد.
تولید متن، تصویر، صدا و ویدئوی مصنوعی میتواند برای آموزش و خلاقیت مفید باشد، اما امکان ساخت جعلهای متقاعدکننده، کلاهبرداری و انتشار اطلاعات گمراهکننده را نیز افزایش میدهد.
آموزش و اجرای برخی مدلهای بزرگ به سختافزار، برق، مراکز داده و زیرساخت شبکه قابلتوجه نیاز دارد. ارزیابی اثر زیستمحیطی باید مصرف انرژی، بهرهوری سختافزار، نوع انرژی و کل چرخه عمر زیرساخت را در نظر بگیرد.
هرچه سیستمها در تصمیمگیریها و اجرای وظایف نقش بیشتری پیدا کنند، تعیین مسئولیت خطا، ثبت فعالیتها، محدودکردن مجوزها و امکان مداخله انسانی اهمیت بیشتری خواهد داشت.
پاسخ به این پرسش به نوع فعالیت و شرایط استفاده بستگی دارد. بهتر است بهجای دستهبندی کامل مشاغل به «قابل جایگزینی» و «غیرقابل جایگزینی»، وظایف تشکیلدهنده هر شغل را بررسی کنیم.
برای مثال، در یک واحد پشتیبانی مشتری، هوش مصنوعی میتواند پیامهای تکراری را دستهبندی کند، پاسخ اولیه پیشنهاد دهد و اطلاعات مورد نیاز را بازیابی کند. اما رسیدگی به شکایت پیچیده، تصمیمگیری درباره استثناها و مدیریت موقعیتهای حساس ممکن است همچنان به قضاوت انسانی نیاز داشته باشد.
در برنامهنویسی نیز مدل میتواند بخشی از کد را تولید کند، اما تعریف نیازمندیها، طراحی معماری، بررسی امنیت و مسئولیت نتیجه نهایی همچنان اهمیت دارند.
بنابراین، یکی از محتملترین مسیرها، تغییر ترکیب وظایف و همکاری میان انسان و ماشین است. البته در برخی حوزهها ممکن است تعداد نیروی مورد نیاز کاهش یابد و در برخی دیگر فرصتهای تازه ایجاد شود. شدت این تغییرات به صنعت، سیاستهای سازمانی و شرایط اقتصادی بستگی دارد.
پیشبینی آینده این فناوری با عدم قطعیت همراه است؛ با این حال، چند مسیر مهم را میتوان دنبال کرد.
مدلها احتمالاً در ترکیب متن، تصویر، صوت و ویدئو توانمندتر خواهند شد. این تحول میتواند تعامل طبیعیتر با نرمافزارها و تحلیل جامعتر اطلاعات را ممکن کند.
سیستمهایی که میتوانند از ابزارها استفاده کنند و وظایف چندمرحلهای را انجام دهند، احتمالاً در کسبوکارها اهمیت بیشتری خواهند یافت. برای استفاده قابلاعتماد، باید حدود اختیارات، امکان بازبینی و شرایط توقف آنها مشخص باشد.
همه کاربردها به بزرگترین مدل موجود نیاز ندارند. مدلهای کوچکتر یا تخصصی ممکن است با هزینه کمتر، تأخیر پایینتر و کنترل بیشتر برای وظایف مشخص مناسب باشند؛ بهویژه هنگامی که دادهها حساساند یا منابع محاسباتی محدود است.
با افزایش استفاده عملی، تنها کیفیت ظاهری پاسخ کافی نخواهد بود. سازمانها به سنجش دقیق خطا، امنیت، پایداری، قابلیت ردیابی و عملکرد سیستم در شرایط واقعی نیاز دارند.
دولتها و نهادهای تخصصی تلاش میکنند برای موضوعاتی مانند حریم خصوصی، تبعیض، شفافیت و مسئولیتپذیری چارچوبهای مناسب ایجاد کنند. قوانین و الزامات در کشورها متفاوتاند و در طول زمان تغییر میکنند.
توانایی تعریف مسئله، ارزیابی خروجی، کار با دادهها، تفکر انتقادی و استفاده مسئولانه از ابزارهای هوشمند احتمالاً اهمیت بیشتری پیدا خواهد کرد. یادگیری نحوه استفاده از هوش مصنوعی بهتنهایی کافی نیست؛ شناخت محدودیتهای آن نیز ضروری است.
هوش مصنوعی عمومی (Artificial General Intelligence یا AGI) اصطلاحی است که معمولاً برای سیستمهایی به کار میرود که بتوانند طیف گستردهای از وظایف شناختی را با انعطافپذیری بالا انجام دهند. با این حال، تعریف دقیق AGI و معیار تشخیص تحقق آن مورد توافق کامل نیست.
مدلهای امروزی در برخی وظایف عملکرد بسیار قدرتمندی دارند، اما این موضوع بهتنهایی اثبات نمیکند که به هوش عمومی انسانی دست یافتهاند. عملکرد آنها ممکن است میان وظایف مختلف نوسان داشته باشد و در موقعیتهای جدید یا نیازمند شناخت دقیق جهان، خطاهای مهمی رخ دهد.
همچنین باید میان هوش عمومی، خودآگاهی و هوش فوقانسانی تمایز قائل شد. این مفاهیم یکسان نیستند و هیچکدام را نمیتوان صرفاً از توانایی تولید متن روان یا حل چند مسئله دشوار نتیجه گرفت.
به همین دلیل، درباره زمان دستیابی به هوش عمومی یا پیامدهای احتمالی آن، باید میان دستاوردهای مشاهدهشده، فرضیههای پژوهشی و پیشبینیهای آینده تفاوت قائل شد.
سیر تحولات هوش مصنوعی نشان میدهد که این فناوری حاصل دههها تلاش در ریاضیات، علوم رایانه، منطق، آمار، علوم اعصاب و مهندسی است. از مدلهای ساده نورون مصنوعی و برنامههای نمادین گرفته تا شبکههای عصبی عمیق، معماری ترنسفورمر و مدلهای مولد، هر نسل بر پایه دستاوردها و محدودیتهای نسلهای پیشین شکل گرفته است.
در این مسیر، دو زمستان هوش مصنوعی یادآوری کردند که وعدههای بزرگ بدون پشتوانه فنی و ارزیابی واقعبینانه کافی نیستند. در مقابل، پیشرفت در دادهها، سختافزار و الگوریتمها نشان داد که ترکیب چند عامل میتواند محدودیتهایی را که سالها پابرجا بودهاند، کاهش دهد.
امروز هوش مصنوعی در حال تغییر شیوه تولید محتوا، تحلیل اطلاعات، توسعه نرمافزار و ارائه خدمات است. با این حال، استفاده موفق از آن تنها به انتخاب یک مدل قدرتمند وابسته نیست؛ کیفیت دادهها، طراحی فرایند، امنیت، نظارت انسانی و ارزیابی نتایج نیز نقشی تعیینکننده دارند.
آینده این فناوری به نحوه توسعه و استفاده از آن بستگی دارد. هوش مصنوعی میتواند ابزاری مؤثر برای افزایش تواناییهای انسان باشد، اما بهرهگیری مسئولانه از آن مستلزم شناخت محدودیتها، بررسی شواهد و حفظ مسئولیتپذیری در تصمیمهای مهم است.
سال ۱۹۵۶ و کارگاه دارتموث معمولاً نقطه آغاز رسمی هوش مصنوعی بهعنوان یک حوزه پژوهشی مستقل در نظر گرفته میشود. با این حال، پایههای نظری آن به پژوهشهای پیشین در منطق، ریاضیات و مدلسازی نورونهای مصنوعی بازمیگردد.
هوش مصنوعی اختراع یک فرد نیست. پژوهشگرانی مانند آلن تورینگ، جان مککارتی، ماروین مینسکی، کلود شنون، فرانک روزنبلات و بسیاری دیگر در شکلگیری این حوزه نقش داشتند. در دورههای بعد نیز گروههای بزرگی از دانشمندان و مهندسان در توسعه آن مشارکت کردند.
پاسخ به تعریف «نخستین» بستگی دارد. مدل ریاضی نورونهای مصنوعی در سال ۱۹۴۳ یکی از پایههای نظری مهم بود. برنامههایی مانند Logic Theorist از نخستین نمونههای شناختهشده حل مسئله با رایانه بودند و ELIZA نیز یکی از نمونههای اولیه گفتوگوی متنی با ماشین به شمار میرود.
زمستان هوش مصنوعی به دورههایی گفته میشود که به دلیل برآوردهنشدن انتظارات، محدودیتهای فنی یا کاهش اعتماد سرمایهگذاران، حمایت مالی و توجه به برخی فعالیتهای این حوزه افت میکند.
هوش مصنوعی سنتی معمولاً برای وظایفی مانند دستهبندی، پیشبینی، تشخیص یا تصمیمگیری طراحی میشود. هوش مصنوعی مولد علاوه بر این کاربردها، برای تولید محتوای جدید مانند متن، تصویر، صوت و کد نیز به کار میرود. این دو گروه همپوشانی دارند و مرز میان آنها همیشه مطلق نیست.
بله. حتی مدلهای پیشرفته ممکن است اطلاعات نادرست تولید کنند، روابط را اشتباه تشخیص دهند یا در شرایطی خارج از محدوده ارزیابیشده عملکرد ضعیفی داشته باشند. خروجیهای حساس باید با منابع معتبر یا بررسی تخصصی کنترل شوند.
پاسخ به معیار انتخاب بستگی دارد. پیشرفت یادگیری عمیق، معرفی ترنسفورمر، توسعه مدلهای زبانی بزرگ و گسترش ابزارهای هوش مصنوعی مولد، هرکدام نقطه عطف مهمی بودهاند. انتشار عمومی ChatGPT در سال ۲۰۲۲ نیز دسترسی کاربران عادی به این فناوری را بهطور چشمگیری گسترش داد.
در برخی وظایف، خودکارسازی و کاهش نیاز به نیروی انسانی محتمل است؛ در برخی دیگر، هوش مصنوعی بیشتر نقش ابزار کمکی را خواهد داشت. نتیجه به نوع فعالیت، هزینهها، کیفیت فناوری، مقررات و نحوه سازماندهی کار بستگی دارد. هیچ پیشبینی واحدی را نمیتوان برای همه مشاغل قطعی دانست.
برای شروع، آشنایی با مفاهیم پایه هوش مصنوعی، منطق و آمار، سپس یادگیری مقدماتی پایتون و مبانی یادگیری ماشین مسیر مناسبی است. پس از آن میتوان بر اساس علاقه، به سمت تحلیل داده، پردازش زبان طبیعی، بینایی ماشین یا مدلهای مولد رفت.
۲. تاریخچه هوش مصنوعی در دانشگاه دارتموث
۳. مقاله علمی Attention Is All You Need درباره معماری ترنسفورمر
۴. پروژه تاریخ هوش مصنوعی؛ مرور رویدادها و پژوهشگران
این مقاله یک مرور تاریخی و آموزشی است. برای استفاده پژوهشی یا استناد علمی، بهتر است تاریخها و جزئیات تخصصی را با مقالات اولیه و منابع دانشگاهی مرتبط نیز تطبیق دهید.
امروزه کیفیت اینترنت موبایل و اینترنت ثابت بیسیم یکی از مهمترین شاخصهای انتخاب اپراتور برای کاربران ایرانی...